决策树回归分析怎么做:分裂规则与变量重要性
决策树回归分析用连续目标的预测均值建立分裂规则,适合需要逐条说明判定条件的预测任务。读结果时先核对交叉验证表现,再看叶节点样本量和变量重要性;一条清晰规则并不意味着它具有稳定的预测能力。
决策树回归分析的数据要怎么排
每行放一个独立对象,目标列是连续数值,其余列是预测时已经掌握的信息。若同一对象有多期记录,随机分折可能把同一对象分到训练与验证两边,普通折外指标就不足以代表对新对象的表现。
以下结果来自本站演示数据(模拟生成,不代表真实研究结论),本例使用完整的 240 行演示记录。方法细节见C&RT决策树,报告中的数据摘要是核对变量与有效观测的入口。
门店的广告投入、面积和促销指标组成这棵树的输入,连续目标是月度销售额。节点阈值沿用输入的原始单位,因此读路径时要保留万元、平方米或百分比的量纲;改用另一单位时应重新核对阈值,不能直接沿用图上的数值。
| 角色 | 建议整理方式 | 阅读重点 |
|---|---|---|
| 连续目标 | 独立的一列数值 | 确认本次为回归任务 |
| 输入指标 | 一列一个特征 | 排除预测时未知的信息 |
| 样本标识 | 保留核对依据 | 检查重复对象与相关记录 |
树把输入空间切成多个区域,每个叶子给出一个区域内的预测均值。它表达的是条件组合对应的预测水平,而不是平滑变化率;跨过一个阈值时预测会阶梯式改变,因此阈值附近的数据质量与叶节点容量都需要核查。
c&rt 分裂规则怎么得到
- 进入「C&RT决策树」并载入演示数据,核对目标为连续列,检查自变量没有包含目标。
- 查看当前深度、叶节点容量和剪枝配置,完成分析后在报告设置表核对实际生效值。
- 先读交叉验证主结果,再读节点明细;沿根节点逐层核对条件,直到对应叶节点。
- 将叶节点的样本数、预测均值和范围一起记录,最后用置换重要性解释模型依赖哪些特征。
回归树的分裂由误差下降决定,节点明细没有自变量效应的 p 值。页面显示了某个变量或阈值,仅说明这个模型用它切分了样本;若要将规则用于操作,应预先定义可接受误差,再在新数据上核验。
折外预测与节点明细怎么看
本次五折交叉验证的 R² 均值为 0.3367,折间标准差 0.2336,RMSE=10.2268。各折波动值得注意,当前树的可读性并没有消除预测的不确定性;训练 R²=0.5875,也高于验证均值。
最终树深度为四,形成 15 个叶节点。根节点以投入指标是否不高于 6.2400 分裂,较低分支有 114 条记录。节点明细显示,叶节点6只有五个样本;解释这种局部规则时,应把有限的样本支持写出来,再考虑能否在新对象中维持相同表现。
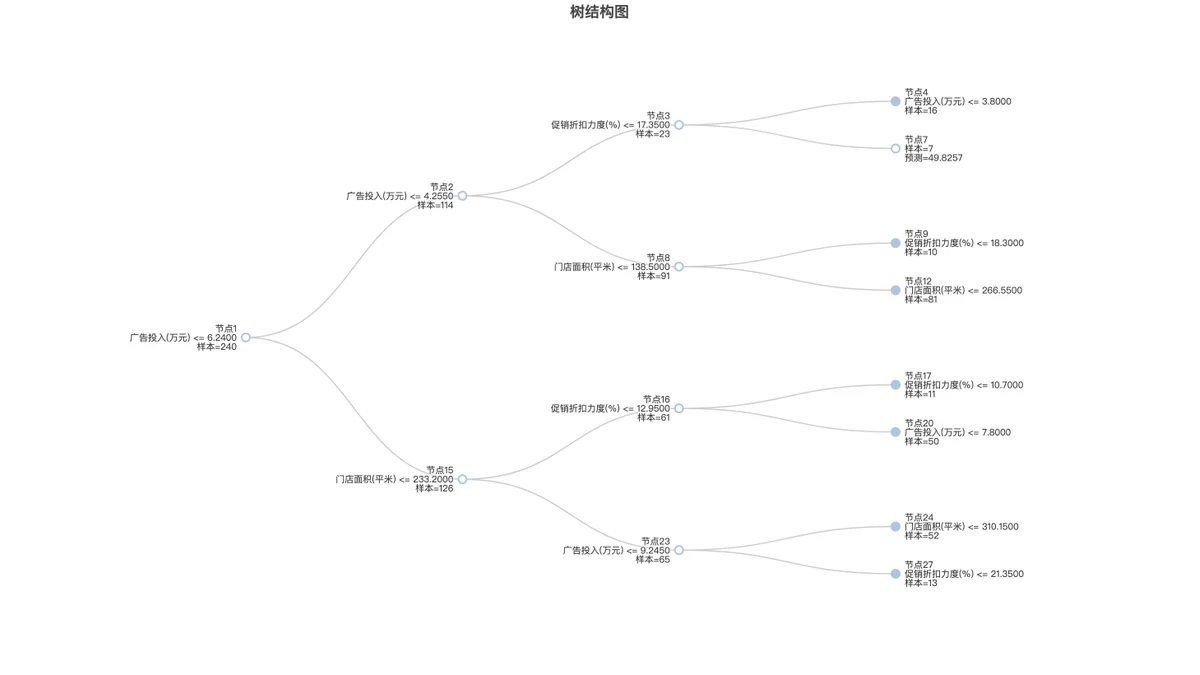
树结构图展示上层分裂,完整路径需与节点明细逐项核对。逐折平均指标与合并全部折外预测后计算的指标可能不同,因为求平均与先合并数据不是同一运算。写报告时应确定一个主口径,另外的指标作为补充,并保留来源表名,避免从不同表中挑出更好看的数字。
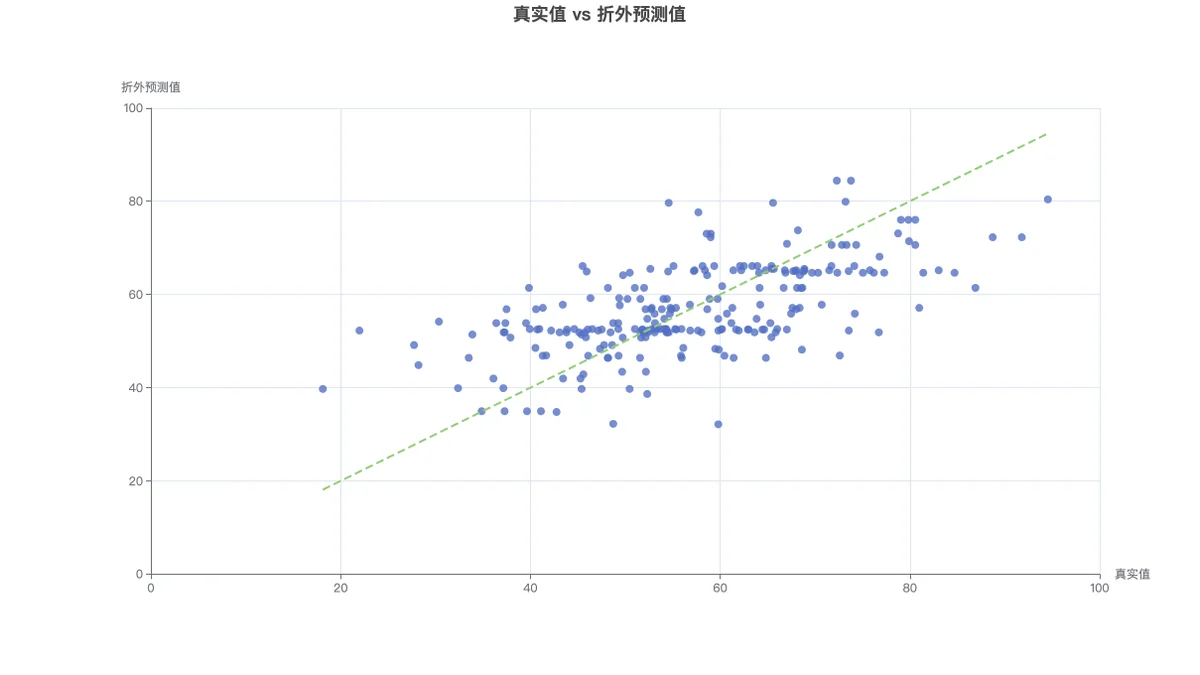
预测散点用于检查预测是否追随真实值,残差用于观察系统性高估或低估。图形上接近目标值的局部区域也可能只对应少数样本,适用范围应与训练数据的覆盖范围一起说明。
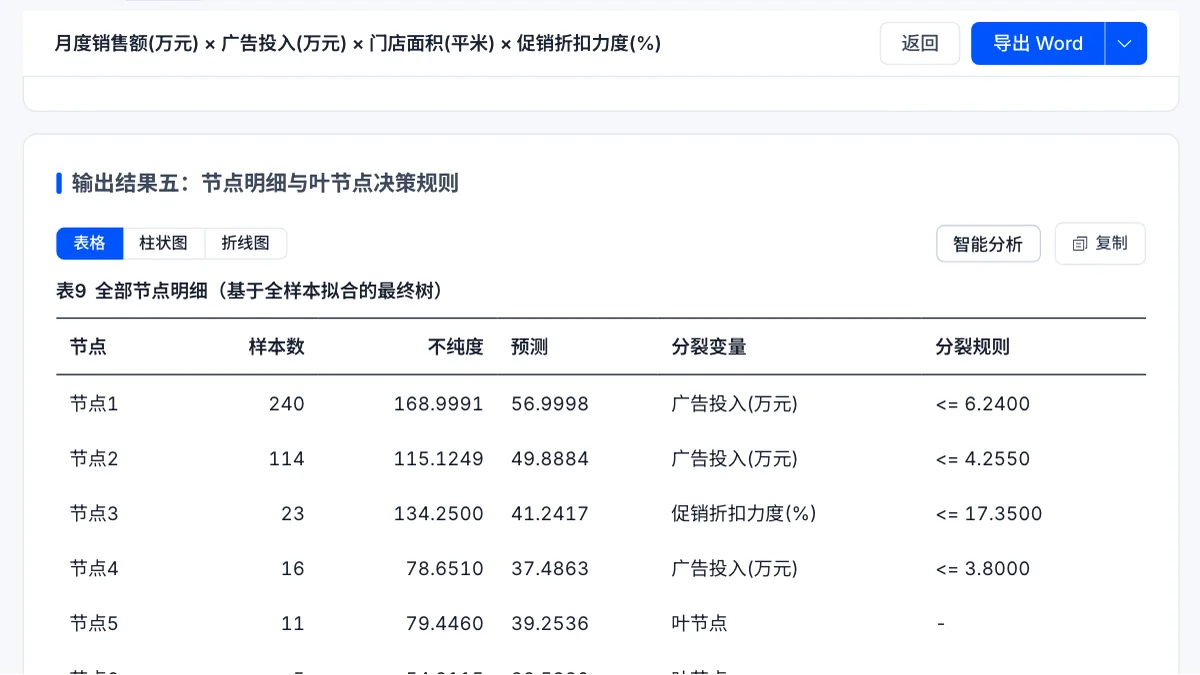
节点明细把路径与样本容量连在一起。两条规则即使预测均值相近,支持它们的样本数与离散程度也可能不同;业务解释应以完整路径为单位,单独摘出一个分裂条件容易遗漏上层节点已经限定的人群。
本例置换重要性依次为广告投入0.63169、门店面积0.28638、促销指标0.11627,表示独立打乱相应输入后R²平均下降多少。这里的排序反映模型的预测依赖,未检验改变某个输入的因果作用;报告同时列出的不纯度重要性完全基于训练集,仅作对照,结论以置换结果为准。
重要性区间只覆盖多次置换的随机波动,没有包含重新采样训练模型的全部不确定性。若输入之间共享信息,单列置换的贡献也会受到其他列补偿,因此应结合特征定义与后续验证解释,避免把排序当作固定不变的变量价值。
决策树回归结果如何写进论文
可写为:采用 C&RT 建立连续目标的回归树,五折交叉验证 R²=0.3367,RMSE=10.2268;最终树含 15 个叶节点。结果用于描述条件组合下的预测,节点分裂未作显著性检验,规则在新样本中的稳定性仍需进一步检验。
方法部分交代目标尺度、输入变量、交叉验证方式与树的约束;结果部分报告折外表现,再描述主要路径及其样本支持。若对深度或剪枝做过选择,还需说明选择过程,随后用未参与选择的数据评价最终规则。
分裂规则常见错误
- 把训练拟合当预测精度:应先报告折外误差,再用训练列观察过拟合。
- 把分裂变量写成显著因素:树在本模块中没有这类检验,应写成规则使用的特征。
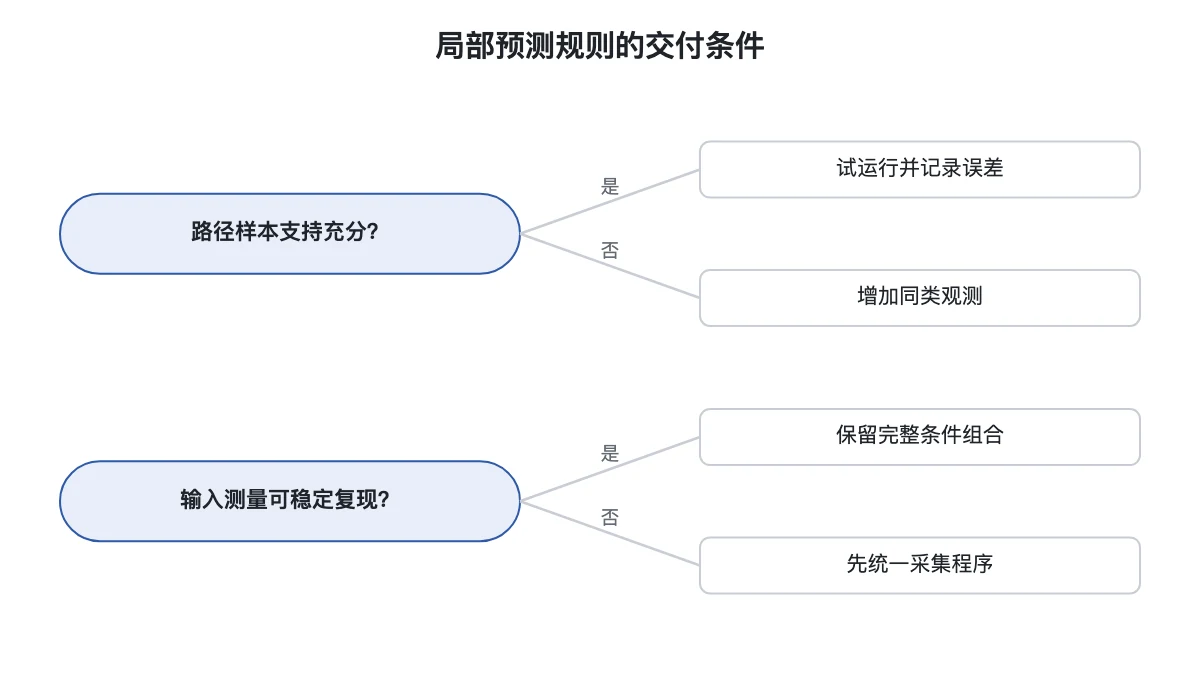
- 省去上层路径:应保留条件的完整组合,避免把局部规则应用到全体对象。
- 忽略小叶节点:同时记录容量和离散程度,将样本稀少的路径列为进一步验证对象。
演示数据不用登录就能跑;用自己的数据分析、导出 Word / PDF 报告、使用 AI 解读需要开通会员。先核对演示报告中的完整路径,再决定自己的数据是否适合规则型预测。
延伸阅读
常见问题
决策树回归分析能说明因果吗?
这里的模型用于预测与结构描述。变量进入模型或贡献较高,只说明与当前预测流程有关,因果判断仍依赖研究设计。
c&rt是否就是显著性?
需要先区分重要性、拟合与假设检验。这里的贡献或规则指标描述模型如何使用变量,不能直接读成效应的显著性。
可以只报告训练结果吗?
应将训练表现与验证表现分开报告。训练数据参与模型建立,评价未来观测的预测能力还需依靠合适的验证数据和设计。